دسته بندی محصولات

صبر کن! کجا می خوای بری؟
قبل از اینکه بری از کد تخفیف Fara10
برای 10% تخفیف خرید استفاده کن
دسته بندی محصولات
قبل از اینکه بری از کد تخفیف Fara10
برای 10% تخفیف خرید استفاده کن
در تحلیلهای آماری، انتخاب روش مناسب برای بررسی داده ها اهمیت زیادی دارد. پژوهشگر قبل از اجرای بسیاری از آزمونهای آماری باید بررسی کند که دادههای جمعآوریشده چه ویژگیهایی دارند و آیا با پیشفرضهای روش مورد استفاده هماهنگ هستند یا خیر. یکی از مهمترین بررسیها در مرحله آمادهسازی دادهها، آزمون نرمال بودن داده ها یا Normality Test است.
اما آزمون نرمال بودن داده ها چیست؟
آزمون نرمال بودن داده ها یک روش آماری برای بررسی این موضوع است که آیا توزیع دادههای یک متغیر از توزیع نرمال پیروی میکند یا خیر. این موضوع اهمیت زیادی دارد، زیرا بسیاری از آزمونهای آماری مانند:
بر اساس فرض نرمال بودن داده ها طراحی شدهاند.
برای مثال، اگر پژوهشگری بخواهد تاثیر یک متغیر بر متغیر دیگر را با استفاده از «رگرسیون چیست؟ تحلیل رگرسیون در پژوهش و پایان نامه» بررسی کند، باید برخی پیشفرضهای آماری آن را کنترل کند که یکی از آنها بررسی وضعیت توزیع داده ها است.
همچنین در تحلیلهای پیشرفته مانند «مدلسازی معادلات ساختاری (SEM) چیست؟ آموزش SEM در پایان نامه» بررسی ویژگیهای داده ها قبل از اجرای مدل اهمیت زیادی دارد.
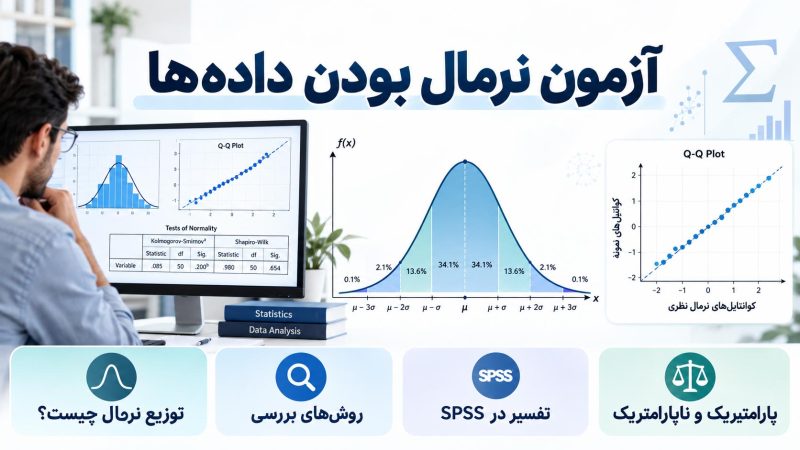
آزمون نرمال بودن داده ها روشی برای بررسی شکل توزیع یک مجموعه داده است. در آمار، توزیع نرمال یکی از مهمترین توزیعهای احتمالی محسوب میشود. بسیاری از روشهای آماری بر این فرض طراحی شدهاند که داده ها یا خطاهای مدل دارای توزیع نزدیک به نرمال هستند.
به زبان ساده، آزمون نرمال بودن داده ها بررسی میکند: آیا دادههای ما الگوی متقارن و مشابه یک منحنی نرمال دارند یا خیر؟
برای مثال، فرض کنید پژوهشگری نمرات رضایت مشتری ۳۰۰ نفر را جمعآوری کرده است. قبل از اجرای برخی تحلیلها باید مشخص شود که این نمرات چگونه در اطراف میانگین توزیع شدهاند. اگر بیشتر داده ها در اطراف میانگین قرار گرفته باشند و پراکندگی آنها الگوی متعادلی داشته باشد، داده ها ممکن است از توزیع نرمال پیروی کنند. اما اگر بیشتر داده ها در یک سمت متمرکز باشند یا دادههای پرت زیادی وجود داشته باشد، توزیع ممکن است نرمال نباشد.
توزیع نرمال یا Normal Distribution یکی از معروفترین توزیعها در علم آمار است. شکل توزیع نرمال معمولاً به صورت یک منحنی زنگولهای نمایش داده میشود.
ویژگیهای اصلی توزیع نرمال:
در بسیاری از تحقیقات علمی، دادههای جمعآوریشده به صورت تقریبی رفتار نرمال دارند و همین موضوع باعث شده است بسیاری از روشهای آماری بر پایه این فرض توسعه پیدا کنند.
بررسی نرمالیتی داده ها به پژوهشگر کمک میکند روش آماری مناسب را انتخاب کند.
برای مثال: اگر داده ها نرمال باشند، معمولاً میتوان از آزمونهای پارامتریک استفاده کرد. اگر داده ها نرمال نباشند، ممکن است آزمونهای ناپارامتریک انتخاب مناسبتری باشند.
نمونهای از این تصمیمگیری:
| وضعیت داده | روش پیشنهادی |
|---|---|
| داده ها تقریباً نرمال | آزمونهای پارامتریک |
| داده ها غیرنرمال | آزمونهای ناپارامتریک |
البته تصمیم نهایی فقط بر اساس یک آزمون نرمالیتی انجام نمیشود و پژوهشگر باید شرایط تحقیق، حجم نمونه و نوع تحلیل را نیز در نظر بگیرد.
بررسی نرمال بودن داده ها یکی از مراحل مهم قبل از تحلیل آماری است، زیرا انتخاب اشتباه آزمون میتواند باعث تفسیر نادرست نتایج شود. مهمترین دلایل بررسی نرمالیتی عبارتاند از:
بسیاری از آزمونهای آماری دارای پیشفرضهایی هستند. برای مثال، در آزمونهای پارامتریک معمولاً فرض میشود که داده ها دارای توزیع مشخصی هستند. اگر این پیشفرض رعایت نشود، ممکن است نتایج آزمون دقت کافی نداشته باشند.
رعایت پیشفرضهای آماری باعث میشود نتایج تحقیق اعتبار بیشتری داشته باشند. در پایان نامهها معمولاً قبل از اجرای تحلیل اصلی، پژوهشگر وضعیت داده ها را بررسی میکند و سپس روش مناسب را انتخاب میکند.
یکی از کاربردهای مهم بررسی نرمالیتی، انتخاب نوع آزمون آماری است.
برای مثال:
انتخاب این آزمونها به شرایط داده ها و هدف تحقیق بستگی دارد.
برای بررسی اینکه داده ها از توزیع نرمال پیروی میکنند یا خیر، روشهای مختلفی وجود دارد. پژوهشگران معمولاً از ترکیبی از روشهای آماری و روشهای گرافیکی استفاده میکنند تا تصمیم دقیقتری بگیرند.
مهمترین روشهای بررسی نرمال بودن داده ها عبارتاند از:
هر کدام از این روشها اطلاعات متفاوتی درباره شکل توزیع داده ها ارائه میدهند.
آزمون کولموگروف اسمیرنوف یا Kolmogorov-Smirnov Test یکی از آزمونهای رایج برای بررسی نرمال بودن داده ها است. این آزمون بررسی میکند که آیا توزیع مشاهدهشده داده ها با یک توزیع مشخص، مانند توزیع نرمال، تفاوت معناداری دارد یا خیر.
در این آزمون دو فرض مطرح میشود:
نتیجه آزمون معمولاً بر اساس مقدار Sig یا همان سطح معناداری تفسیر میشود.
آزمون شاپیرو ویلک یا Shapiro-Wilk Test یکی دیگر از روشهای بررسی نرمال بودن داده ها است. این آزمون به ویژه برای حجم نمونههای کوچک و متوسط کاربرد زیادی دارد و در بسیاری از پژوهشهای دانشگاهی استفاده میشود.
مانند آزمون کولموگروف اسمیرنوف، در شاپیرو ویلک نیز:
تفسیر مقدار Sig:
انتخاب بین کولموگروف اسمیرنوف و شاپیرو ویلک به عواملی مانند حجم نمونه و روش تحقیق بستگی دارد.
هر دو آزمون برای بررسی نرمالیتی داده ها استفاده میشوند، اما تفاوتهایی بین آنها وجود دارد.
| ویژگی | کولموگروف اسمیرنوف | شاپیرو ویلک |
|---|---|---|
| کاربرد اصلی | نمونههای بزرگتر | نمونههای کوچک و متوسط |
| حساسیت | کمتر در برخی شرایط | حساسیت بیشتر |
| استفاده رایج | SPSS و تحقیقات عمومی | پژوهشهای آماری دقیقتر |
| خروجی اصلی | مقدار Sig | مقدار Sig |
در عمل، بسیاری از پژوهشگران علاوه بر آزمونهای آماری، نمودارها و شاخصهای توصیفی را نیز بررسی میکنند. زیرا در نمونههای بزرگ، آزمونهای نرمالیتی ممکن است حتی انحرافهای کوچک را نیز معنادار نشان دهند.
علاوه بر آزمونهای آماری، روشهای گرافیکی نیز برای بررسی وضعیت داده ها استفاده میشوند. این روشها دید بهتری درباره شکل واقعی توزیع داده ها ارائه میدهند.
هیستوگرام یکی از سادهترین روشها برای مشاهده شکل توزیع داده ها است. در این نمودار، فراوانی داده ها در بازههای مختلف نمایش داده میشود. اگر داده ها نرمال باشند، شکل کلی هیستوگرام معمولاً شبیه یک منحنی زنگولهای خواهد بود.
در بررسی هیستوگرام باید به موارد زیر توجه کرد:
البته تصمیمگیری فقط بر اساس شکل هیستوگرام توصیه نمیشود و بهتر است همراه با آزمونهای آماری استفاده شود.
نمودار Q-Q Plot یا Quantile-Quantile Plot یکی دیگر از روشهای بررسی نرمال بودن داده ها است. در این نمودار، مقادیر واقعی داده ها با مقادیر مورد انتظار در یک توزیع نرمال مقایسه میشوند. ا
SPSS یکی از رایجترین نرمافزارها برای بررسی نرمالیتی داده ها است. برای اجرای آزمون نرمال بودن داده ها در SPSS معمولاً از مسیر زیر استفاده میشود:
Analyze ↓ Descriptive Statistics ↓ Explore
در پنجره بازشده:
پس از اجرای تحلیل، SPSS خروجیهایی مانند موارد زیر ارائه میدهد:
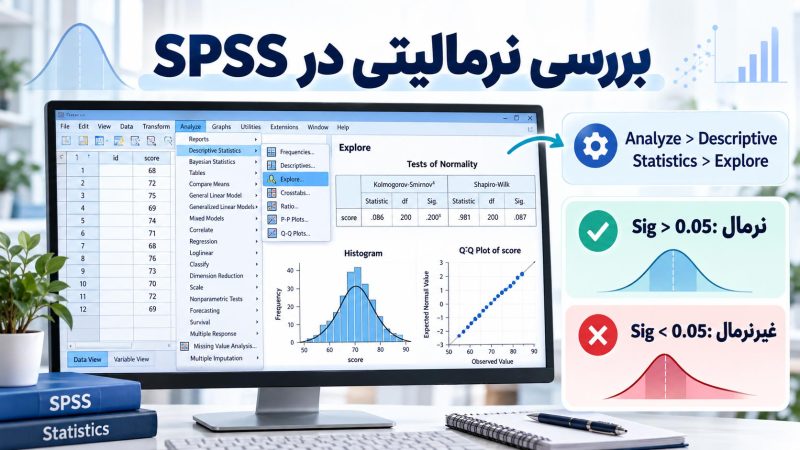
مهمترین بخش خروجی، جدول Tests of Normality است. در این جدول معمولاً دو آزمون نمایش داده میشود:
نمونه تفسیر:
یکی از مهمترین دلایل بررسی نرمال بودن دادهها، انتخاب روش آماری مناسب است. بسیاری از آزمونهای آماری بر اساس این فرض طراحی شدهاند که داده ها یا خطاهای مدل از توزیع نرمال پیروی میکنند. اگر این پیشفرض رعایت نشود، ممکن است نتایج تحلیل دقت کافی نداشته باشند یا تفسیر آنها با مشکل مواجه شود. به طور کلی، آزمونهای آماری به دو گروه اصلی تقسیم میشوند:
آزمونهای پارامتریک روشهایی هستند که معمولاً بر اساس فرضهایی درباره توزیع داده ها طراحی شدهاند. یکی از مهمترین این فرضها، نرمال بودن داده ها است. نمونههایی از آزمونهای پارامتریک:
برای مثال، در یک پژوهش که هدف آن بررسی تاثیر یک عامل بر عامل دیگر است، ممکن است از «رگرسیون چیست؟ تحلیل رگرسیون در پژوهش و پایان نامه» استفاده شود. در این روش، بررسی برخی پیشفرضها مانند نرمال بودن خطاها اهمیت دارد.
آزمونهای ناپارامتریک زمانی استفاده میشوند که داده ها شرایط لازم برای آزمونهای پارامتریک را نداشته باشند. این آزمونها معمولاً وابستگی کمتری به فرض نرمال بودن داده ها دارند. برخی از آزمونهای ناپارامتریک عبارتاند از:
انتخاب بین آزمون پارامتریک و ناپارامتریک باید بر اساس هدف تحقیق، نوع متغیرها، حجم نمونه و شرایط داده ها انجام شود.
رگرسیون یکی از روشهای پرکاربرد تحلیل آماری است که برای بررسی رابطه بین متغیرها استفاده میشود. اما اجرای صحیح رگرسیون نیازمند بررسی چندین پیشفرض آماری است. مهمترین پیشفرضهای رگرسیون شامل موارد زیر هستند:
نکته مهم این است که در رگرسیون معمولاً نرمال بودن خود متغیرها به تنهایی معیار اصلی نیست، بلکه توزیع خطاهای مدل یا باقیماندهها اهمیت زیادی دارد. به همین دلیل، پژوهشگر باید قبل از تفسیر نتایج رگرسیون، شرایط مدل را بررسی کند.
در روشهایی مانند تحلیل مسیر و مدلسازی معادلات ساختاری، بررسی وضعیت داده ها اهمیت زیادی دارد. در مدلسازی معادلات ساختاری، نوع روش انتخابی میتواند بر اهمیت نرمال بودن داده ها تاثیر بگذارد. برای مثال:
در تحلیل مسیر نیز قبل از بررسی روابط بین متغیرها، پژوهشگر باید کیفیت داده ها و پیشفرضهای آماری را بررسی کند. به همین دلیل، در مسیر انجام یک پژوهش کمی معمولاً این مراحل دنبال میشود:
طراحی پرسشنامه ↓ بررسی «روایی و پایایی پرسشنامه چیست؟» ↓ بررسی نرمال بودن داده ها ↓ انتخاب روش تحلیل ↓ اجرای رگرسیون، تحلیل مسیر یا SEM
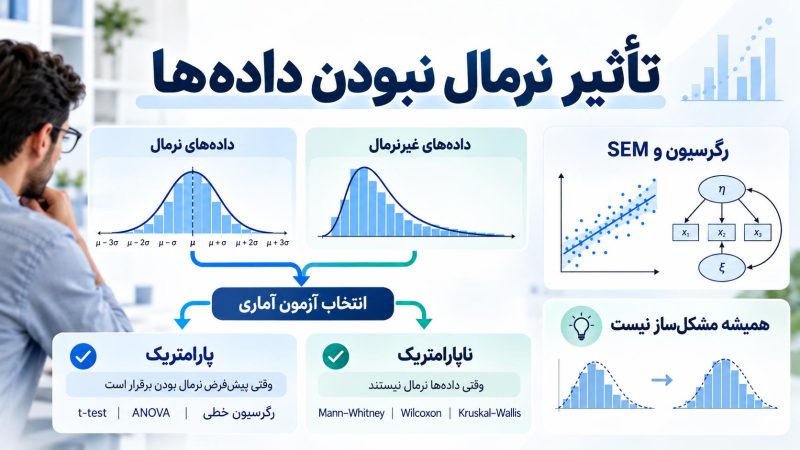
خیر. غیرنرمال بودن داده ها همیشه به این معنی نیست که امکان انجام تحلیل آماری وجود ندارد. در بسیاری از تحقیقات، مخصوصاً زمانی که حجم نمونه بزرگ باشد، برخی روشهای آماری نسبت به انحرافهای جزئی از نرمال بودن مقاوم هستند. همچنین برخی روشها مانند PLS-SEM وابستگی کمتری به فرض نرمال بودن داده ها دارند.
بنابراین، پژوهشگر نباید فقط بر اساس نتیجه یک آزمون نرمالیتی تصمیم بگیرد. برای تصمیمگیری بهتر باید موارد زیر بررسی شوند:
برخی خطاها در بررسی نرمالیتی میتواند باعث انتخاب اشتباه روش تحلیل شود.
یکی از اشتباهات رایج این است که پژوهشگر فقط به مقدار معناداری آزمون نرمالیتی توجه کند. در نمونههای بزرگ، ممکن است کوچکترین انحراف از توزیع نرمال نیز باعث معنادار شدن آزمون شود. به همین دلیل بهتر است آزمون آماری همراه با نمودارها و شاخصهای توصیفی بررسی شود.
نوع داده، حجم نمونه و هدف تحقیق تعیین میکند که کدام روش بررسی نرمالیتی مناسبتر است. استفاده از یک روش ثابت برای تمام پژوهشها ممکن است نتیجه دقیقی ایجاد نکند.
وجود دادههای پرت میتواند باعث تغییر شکل توزیع داده ها شود. قبل از نتیجهگیری درباره نرمال بودن دادهها، بررسی دادههای پرت اهمیت زیادی دارد.
آزمون نرمال بودن داده ها چیست؟ این آزمون مجموعهای از روشهای آماری و گرافیکی برای بررسی وضعیت توزیع داده ها است و به پژوهشگر کمک میکند روش تحلیل مناسب را انتخاب کند.
آزمونهایی مانند کولموگروف اسمیرنوف و شاپیرو ویلک از رایجترین روشهای بررسی نرمالیتی هستند. همچنین استفاده از نمودارهایی مانند هیستوگرام و Q-Q Plot میتواند تصویر دقیقتری از رفتار داده ها ارائه دهد.
بررسی نرمال بودن داده ها یکی از مراحل مهم قبل از اجرای بسیاری از تحلیلهای آماری مانند رگرسیون، تحلیل مسیر، آزمون t و تحلیل واریانس است. با این حال، تصمیمگیری درباره انتخاب روش آماری نباید فقط بر اساس یک شاخص انجام شود و باید شرایط کلی پژوهش، حجم نمونه و هدف تحلیل نیز در نظر گرفته شود.
در تیم فرابگیر، ما تخصص داریم تا شما روی اهداف اصلی تمرکز کنید. از ایده تا اجرا، همراه شما هستیم.
آزمون نرمال بودن داده ها روشی برای بررسی این موضوع است که آیا دادههای یک متغیر از توزیع نرمال پیروی میکنند یا خیر.
آزمون شاپیرو ویلک و کولموگروف اسمیرنوف از رایجترین آزمونها هستند. انتخاب روش مناسب به حجم نمونه و نوع تحقیق بستگی دارد.
اگر مقدار Sig بیشتر از ۰.۰۵ باشد، معمولاً داده ها نرمال در نظر گرفته میشوند.
بله. بسته به روش آماری، حجم نمونه و هدف تحقیق، میتوان از روشهای مناسب برای تحلیل دادههای غیرنرمال استفاده کرد.
بله، بررسی پیشفرضهای رگرسیون اهمیت دارد، اما در رگرسیون بیشتر نرمال بودن باقیماندههای مدل مورد توجه قرار میگیرد.